
Jeg ga Claude en ekstern harddisk med to timer opptak fra en fjelltur med bestevennen min, og ba den om å finne alle klippene der vi snakker sammen og ler. Halvannen time senere lå 49 ferdig utklippede segmenter i en ny mappe, sortert etter hvor sikker maskinen var på seg selv. Den hadde ikke hørt en eneste lyd, ikke forstått en eneste vits, og likevel funnet nesten alt.
Rikard og jeg har gått turer sammen siden 2020. Det har blitt over 120 videoer på YouTube-kanalen min, under spillelisten Naturopplevelser. Det folk ser der, er fem til 35 minutter. Det de ikke ser, er alt det andre jeg filmet som ikke fikk plass i videoen. For hver eneste YouTube-video ligger det timevis med opptak igjen på en harddisk. Mesteparten av det blir liggende usett for alltid.
Abonner på YouTube-kanalen min nå
//Artikkelen fortsetter etter annonsen//

I juni 2024 gikk Rikard og jeg mot Møysalen på Hinnøya, Vesterålens høyeste fjell på 1.262 meter. Vi kom aldri helt til toppen. Det spiller mindre rolle her, for det jeg var ute etter denne gangen var noe annet enn fjelltopper. Jeg ville finne øyeblikkene der Rikard og jeg sitter og prater og ler sammen. Ikke for å lage en ny YouTube-video. Bare for oss å se tilbake på.
Det er en jobb jeg aldri har gjort, fordi den aldri har vært verdt å gjøre.
Halvannen time på en jobb jeg aldri ville betalt noen for
Mappen inneholdt 113 videoklipp fra den turen, til sammen to timer og to minutter. Jeg koblet harddisken til Claude, forklarte at jeg ville den skulle lete etter klipp hvor Rikard og jeg snakket med hverandre, men kun hvor Rikard og jeg lo sammen.
Så lot jeg den jobbe.
Resultatet var en ny mappe med 49 klipp på til sammen 13 minutter, fordelt på tre undermapper etter hvor sannsynlig det var at treffet holdt vann, og med en oversiktsfil som for hvert klipp viste tidspunkt i originalen, hvor mye latter som var målt, hvor mange replikkvekslinger det var mellom oss, og hva som ble sagt.
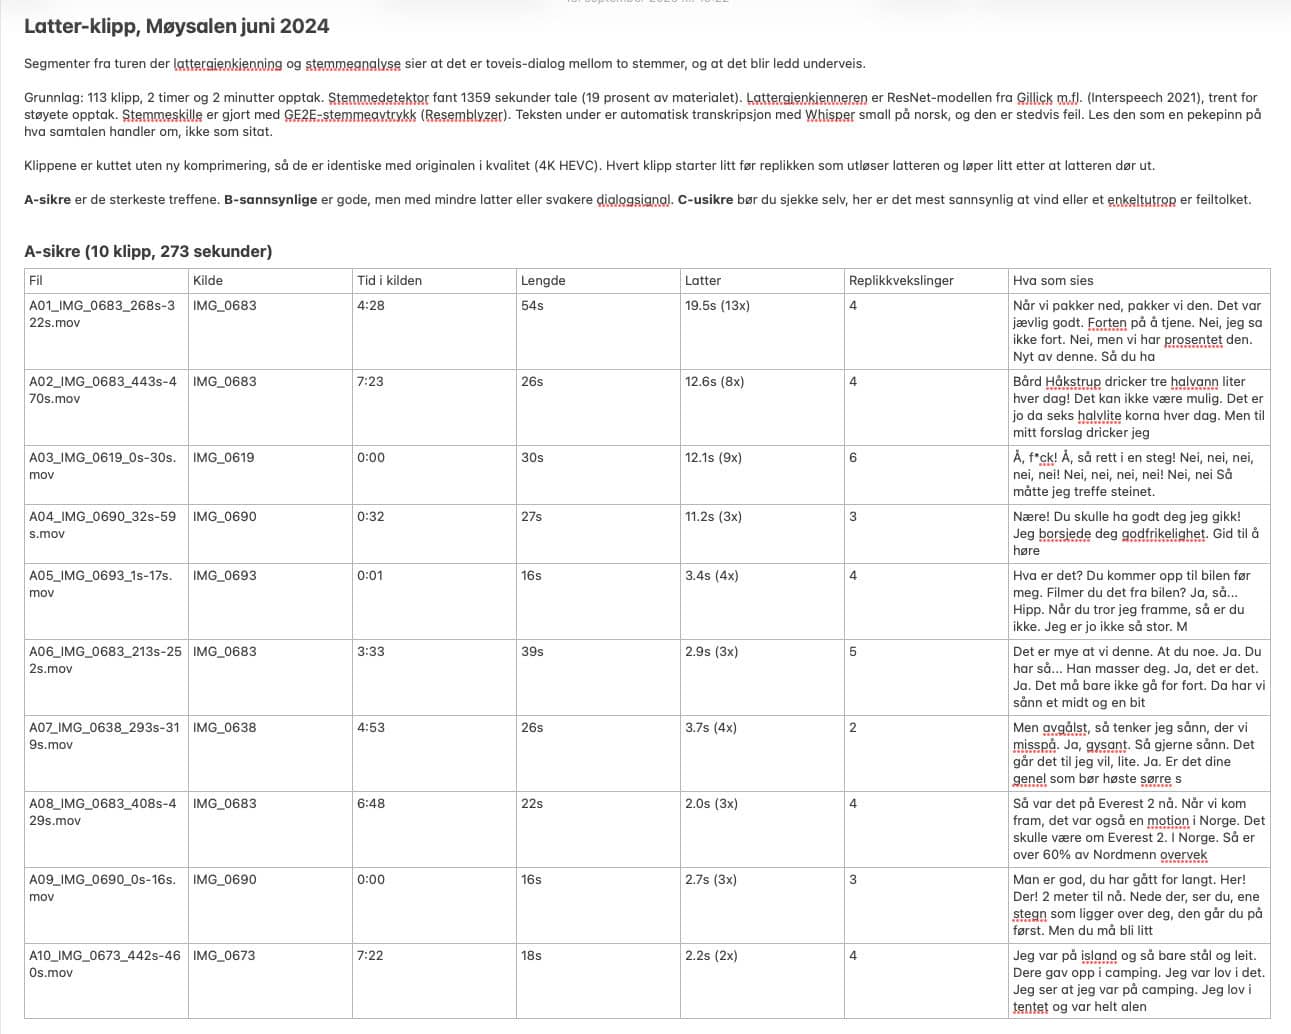
Skjermdump av oversikten Claude satt opp av de klippene «han» mente inneholdt latter, sortert på sikre, sannsynlige og usikre.
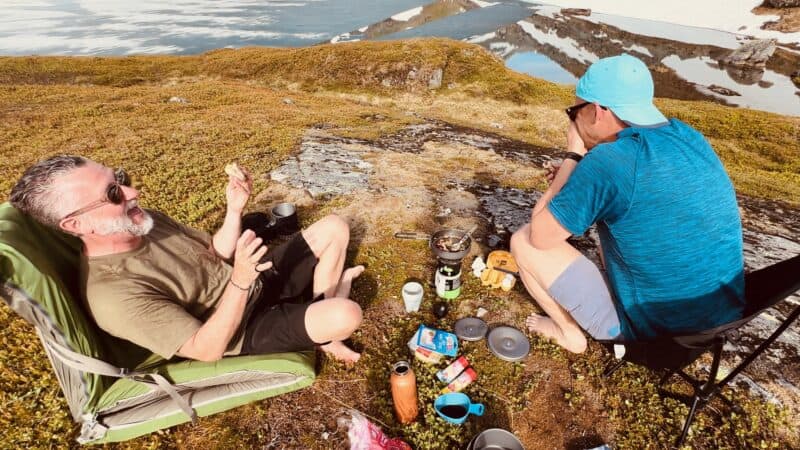
Ti av klippene var sikre, ifølge Claude. Det beste av dem er 54 sekunder fra leiren ved vannet, der Rikard og jeg sitter i hver vår campingstol med primusen mellom oss, og ler i nesten tjue av de sekundene.
Abonner på YouTube-kanalen min nå
//Artikkelen fortsetter etter annonsen//
Slik gikk maskinen frem, steg for steg
Dette er den delen jeg mener fortjener mest plass, fordi den sier noe vesentlig om hva slags intelligens vi faktisk har med å gjøre. Er du ikke teknisk interessert, kan du hoppe til neste kapittel. Men jeg vil anbefale at du leser den, for det er her det blir tydelig hvor lite dette har med (menneskelig) forståelse å gjøre.
Claude hører ikke. Den har ingen ører, ingen lyd, ingen opplevelse av at noe er morsomt. Det den gjorde, var å sette sammen en kjede av ni spesialiserte verktøy og lese resultatet av dem. Alle er fritt tilgjengelige, og alle er lenket opp nederst i denne artikkelen.
For ordens skyld: Forklaringen under er skrevet av Claude selv!
Først måtte den skille ut riktig tur. Mappen inneholdt mer enn Møysalen. Der lå 34 filer fra en helt annen tur i januar 2024, tre ferdigredigerte eksporter med musikk, prosjektfiler fra Filmora, seks mp3-filer og over 160 skjulte systemfiler som macOS legger igjen uten at man ser dem. Claude leste tidsstempler og filstørrelser, ikke innhold, og skilte ut de 113 klippene som faktisk var filmet i juni 2024.
Så ble lyden løsnet fra bildet med ffmpeg. ffmpeg er et åpent kildekode-verktøy som har eksistert siden 2000, og som i praksis ligger under nesten alt som håndterer video på internett, fra strømmetjenester til mobilapper. Claude ba det trekke ut bare lydsporet fra hvert av de 113 klippene og konvertere det til 16 kilohertz mono i formatet FLAC. FLAC er tapsfri komprimering, altså som en zip-fil for lyd. Det valget var bevisst: en vanlig mp3-fil kaster bort akkurat de fine detaljene i frekvensbildet som en lattermodell ser etter. Førti gigabyte med 4K-video ble til 229 megabyte med lyd. Søsterverktøyet ffprobe målte hvert klipp og summerte materialet til 7.314 sekunder.
Deretter ryddet Silero VAD bort alt som ikke var stemmer. VAD står for voice activity detection. Silero er et lite nevralt nettverk på rundt to megabyte som for hver 32. millisekund av lyd svarer på ett spørsmål: er det et menneske som snakker her? Det gikk gjennom hele materialet på 83 sekunder og fant 1.359 sekunder med tale. Det er 19 prosent. Hele 58 av de 113 klippene inneholdt ingen tale i det hele tatt, stort sett landskapsopptak og mindre videosnutter med bare vind. Dette steget er ren økonomi. Fire femtedeler av arkivet ble luket bort før den dyre modellen fikk se noe som helst.
Så ble lyden gjort om til et bilde med librosa. librosa er et Python-bibliotek for lydanalyse. Det laget et mel-spektrogram av hvert taleområde, altså en tabell der den ene aksen er tid, den andre er frekvens, og verdien er hvor mye energi lyden har akkurat der. Konkret: lyden ble nedskalert til 8 kilohertz, delt inn i 43 bilder per sekund, og hvert bilde beskrevet med 128 frekvensbånd. Ett sekund med lyd blir da en tabell på 44 ganger 128, altså 5.632 tall. Det er dette lattermodellen faktisk får se. Ikke lyd. Et rutenett med tall.
Så kom selve lattergjenkjenningen. Modellen er et nevralt nettverk av typen ResNet med 812.000 parametere, publisert av Jon Gillick, Wesley Deng, Kimiko Ryokai og David Bamman ved Berkeley på Interspeech i 2021. Den er trent på Switchboard, en samling amerikanske telefonsamtaler fra 1990-tallet der mennesker har merket av nøyaktig hvor folk ler, og den er gjort robust mot støy ved å blande inn lyd fra Googles AudioSet. Nettopp støyrobustheten var avgjørende her, siden halve turen er filmet i kuling.
Modellen fikk servert ett sekund om gangen, forskjøvet 21,5 ganger i sekundet, og svarte hver eneste gang på det samme spørsmålet: hvor mye ligner dette rutenettet med tall på de rutenettene mennesker har merket som latter? Det ble gjennomført 36.881 slike vurderinger. Hver av dem endte i ett tall mellom 0 og 1. SciPy, et matematikkbibliotek, glattet ut kurven av tall med et Butterworth-filter, slik at en enkelt topp ikke telte som latter. For å bli godkjent måtte sannsynligheten holde seg over 0,6 i minst 0,4 sekunder. Resultatet var 110 latterhendelser fordelt på 25 av de 113 klippene.
Modellen vet ikke at noen lo. Den har ingen anelse om at noe var morsomt. Den produserer et tall.
Deretter skilte Resemblyzer de to stemmene. Jeg ba ikke om latter generelt, jeg ba om dialog mellom oss to. Resemblyzer er en åpen implementasjon av Googles GE2E-modell, beskrevet av Li Wan, Quan Wang, Alan Papir og Ignacio Lopez Moreno i 2017. Den gjør enhver taleytring på minst et halvt sekund om til 256 tall, et slags stemmeavtrykk. Er det samme person som snakker, peker de to tallrekkene nesten samme vei. Er det to forskjellige, spriker de.
Hver eneste taleytring innenfor tjue sekunder på hver side av en latter ble gjort om til et slikt avtrykk og gruppert i to. Var de to gruppene tilstrekkelig langt fra hverandre, var det to stemmer til stede, og da telte Claude hvor mange ganger samtalen vekslet mellom dem. 99 av de 110 latterhendelsene lå inne i en toveis-dialog med minst én replikkveksling.
Modellen vet ikke hvem av oss som er hvem. Den vet at det finnes to klynger i et 256-dimensjonalt rom. Geometri, ikke identitet.
Så kom transkripsjonen med Whisper. Whisper er OpenAIs talegjenkjenningsmodell fra 2022, og den ble her kjørt gjennom sherpa-onnx, et rammeverk fra det åpne k2-fsa-prosjektet, med modellen komprimert ned til åtte biters presisjon for å kunne kjøre på vanlig prosessor. Språket var satt til norsk.
Første forsøk var med den mellomstore modellen. Den brukte 427 sekunder på å tyde 30 sekunder lyd, og gikk i tillegg i en repetisjonsløkke og skrev «ja, ja, ja» femti ganger på rad. Claude byttet til den mindre modellen, som tydet 28 sekunder lyd på 14 sekunder og ga lesbar tekst. Alle de 49 kandidatene ble transkribert på 701 sekunder. Også dette er mønstergjenkjenning. Modellen finner den mest sannsynlige tekstsekvensen gitt lyden, ikke meningen i den.
Så kom det eneste steget som ligner på resonnement. Claude leste alle transkripsjonene, slo sammen latterhendelser som overlappet, og ga hvert segment en samlet poengsum basert på fem vektede signaler: hvor lenge latteren varte, hvor høy topp den nådde, hvor mange separate latterutbrudd segmentet inneholdt, hvor mange ganger stemmene vekslet, og hvor mye faktisk samtale transkripsjonen inneholdt. Deretter sorterte den i tre grupper etter egen sikkerhet.
Og så kom det eneste steget som involverte ekte syn. ffmpeg trakk ut stillbilder på lattertoppene, og Claude så på dem som bilder. Det var der bildet av Rikard og meg i hver vår campingstol ved vannet dukket opp. Det var også der det ble klart at et av klippene bare viste bakken, fordi kameraet hang i hånden mens vi gikk og pratet.
Til slutt klippet ffmpeg ut segmentene. Uten ny komprimering, altså ved å løfte bitene rett ut av originalfilen og legge dem i en ny. Seks gigabyte med 4K i HEVC-format, bit for bit identisk med kilden.
Fra jeg koblet til harddisken til de 49 klippene lå ferdig sortert i en ny mappe, gikk det i underkant av halvannen time.
//Artikkelen fortsetter etter annonsen//

Modellene måtte hentes inn bakveien
Her er en detalj jeg mener fortjener plass, fordi den sjelden nevnes i artikler om kunstig intelligens. Verken Hugging Face, som er den vanlige distribusjonskanalen for åpne AI-modeller, eller OpenAIs egen modellserver var tilgjengelig fra miljøet jobben kjørte i. Nettverksreglene stengte dem ute.
Prosjektet mitt kunne fort ha stoppet der.
Claude løste derimot dette ved å finne andre veier. Whisper-modellen ble hentet som en vedlagt fil fra en programvareutgivelse på GitHub i k2-fsa-prosjektet. Silero og Resemblyzer viste seg å levere modellvektene sine inne i selve Python-pakken, slik at de fulgte med på installasjonen. Lattermodellens vekter lå sjekket inn i Gillicks eget kodearkiv.
Dette er trivielt for en utvikler og uinteressant for alle andre, men det er nøyaktig den typen hindring som avgjør om et prosjekt blir gjennomført eller ikke.
Koden var fem år gammel og virket ikke
Gillicks kode er fra 2021 og forutsetter programvareversjoner som for lengst er gått ut på dato. På et moderne oppsett krasjet den seks ganger på rad, og hver gang av en ny grunn.
En modul i biblioteket praatio hadde skiftet navn. En funksjon kalt pkg_resources var fjernet i nyere versjoner av setuptools. Biblioteket nltk manglet helt. PyTorch hadde av sikkerhetshensyn endret standardinnstillingen for å laste inn gamle modellfiler, og nektet. librosa hadde sluttet å godta argumenter i den rekkefølgen koden brukte. Og np.unicode_ var slettet i NumPy 2.0.
Ingen av disse seks feilene har noe med kunstig intelligens å gjøre. Det er alminnelig vedlikeholdsarbeid, av typen en utvikler bruker en formiddag på. Claude leste feilmeldingene, forsto hva hver av dem faktisk betydde, og rettet dem én etter én.
Jeg tar det med fordi det er akkurat den typen arbeid vi pleier å ta for gitt at trenger et menneske.
Tolv timer ble til 23 minutter
Første måling var nedslående. På to prosessorkjerner, uten grafikkort, klarte lattermodellen syv vurderinger i sekundet. Skulle den gå gjennom hele materialet bilde for bilde i det tempoet, ville jobben tatt over tolv timer.
Claude gjorde tre grep. Den brukte stemmedetektoren til å fjerne 81 prosent av materialet før modellen fikk se det. Den lot modellen hoppe over annethvert bilde, siden latter uansett varer lenger enn et halvt sekund. Og den konverterte modellen fra PyTorch til formatet ONNX og kjørte den gjennom ONNX Runtime, som er optimalisert for nettopp denne typen beregning på vanlig prosessor. Det siste grepet alene gjorde den 2,8 ganger raskere, fra syv til atten vurderinger i sekundet.
Samlet gikk jobben fra over tolv timer til 23 minutter. Det er en forbedring på over tretti ganger, oppnådd på egen hånd, mellom to av mine egne spørsmål.
Jeg mener dette er den mest undervurderte delen av hele historien. Det oppsiktsvekkende er ikke at en modell kan gjenkjenne latter. Det er at noe kan sette sammen ni forskjellige verktøy, oppdage at kombinasjonen er for treg, forstå hvorfor, og bygge om løsningen uten å spørre meg om lov.
//Artikkelen fortsetter etter annonsen//
Hele jobben brukte mindre strøm enn én varm dusj
Da jeg fortalte sønnen min om dette prosjektet, forventet jeg i utgangspunktet at han skulle bli mektig imponert. Samtidig var jeg ikke overrasket over at han lurte på hvor mye energi og vann som ble forbrukt.
Han er ung og som mange andre i dag, opptatt av klima, miljø og bærekraft. Det er bra, for bærekraftselementet er viktig her. Derfor fikk jeg også Claude til å regne på det. Og bare så det er klart; tallene under er anslag, ikke målinger, og de bør leses deretter.
- Først fordelingen, som er verdt å merke seg fordi den ikke er slik folk flest antar. Alt som hadde med bearbeiding av selve videofilene kjørte på min Apple MacBook Air M2 fra hjemmekontoret mitt. Uttrekket av lyd fra alle 113 klippene, målingen av dem, stillbildene og hele utklippingen av de 49 ferdige segmentene. Det var også her de store datamengdene ble flyttet, siden over 40 gigabyte ble lest fra den eksterne disken. Videoene forlot aldri harddisken min. Det eneste som gikk til skyen var 229 megabyte lyd.
- I datasenteret kjørte modellene, altså stemmedeteksjonen, lattergjenkjenningen, stemmeavtrykkene og transkripsjonen. Rundt en time på to prosessorkjerner, uten grafikkort. Og i tillegg, separat fra det, kjørte selve språkmodellen som leste transkripsjonene, rettet den gamle koden og tok avgjørelsene. Det er den klart største posten, og den vanskeligste å anslå.
- Min Apple MacBook Air M2 brukte rundt ti wattimer. Prosessorarbeidet i datasenteret rundt tjue. Dataoverføringen et sted mellom fem og femti, avhengig av hvilken beregningsmåte man legger til grunn, og det er det svakeste tallet i hele regnestykket. Språkmodellen selv, med over sytti turer i en samtale med stor kontekst, havner et sted mellom 0,2 og 0,9 kilowattimer. Samlet sett rundt 0,4 kilowattimer. Det tilsvarer en vannkoker på full guffe i tolv minutter, to kilometer i elbil, eller tretten minutter av gjennomsnittsforbruket til en norsk husholdning gjennom døgnet.
- Vannet deler seg i to poster, og nesten all forvirring i denne debatten kommer av at de blandes sammen. Kjølevann på stedet måles i WUE. Amazon oppga i år 0,12 liter per kilowattime for sine datasentre i 2025, mens bransjesnittet oppgis til alt fra 0,84 til 1,9 liter avhengig av hvem som teller og hva de teller med. Den andre posten er vannet som går med til å produsere strømmen, og den nevnes nesten aldri. I USA ligger den rundt 4,5 liter per kilowattime, fordi kull- og gasskraftverk fordamper store mengder kjølevann. Til sammen havner dette prosjektet et sted mellom to desiliter og to liter vann. En varm dusj på ti minutter bruker rundt 3,5 kilowattimer bare til å varme vannet, og tapper i underkant av hundre liter. Det er ni ganger energien og over hundre ganger vannet som gikk med til hele dette prosjektet. Personlig dusjer jeg et sted mellom tre og fem minutter, mens jeg hører om bærekrafts-fokusert ungdom som dusjer 20 og 30 minutter, og som gjerne gjør hver eneste dag gjennom hele uken. Og sønnen min, som først og fremst var opptatt av energi og vann, kan sitte på rommet sitt i fem til syv timer på en god dag (og ofte flere ganger i løpet av en uke) og game med andre online. Etter litt Claude-hjelp fant vi ut at én time online-gaming bruker omtrent like mye strøm som hele Møysalen-prosjektet gjorde for å finne frem og lagre klippene der Rikard og jeg snakker og ler sammen. Hadde jeg fått Claude til å gjøre tilsvarende operasjon for samtlige av mine YouTube-videoer fra alle naturopplevelsene mine, hadde det kostet det samme (i vann og strøm) som én lang gaming-dag, tilsvarende 90 minutter med sammenhengende dusjing.
Summen er et helt annet regnestykke enn enkelttilfellet
Jeg kunne stoppet der og erklært meg frikjent. Det ville vært en billig seier, og jeg tror den typen argumentasjon er en vesentlig grunn til at denne debatten står på stedet hvil. For sammenligningen med dusjen og gamingen til sønnen min beviser egentlig bare at ett enkelt tilfelle er trivielt. Det har aldri vært påstanden fra dem som er bekymret.
Ingen mener at én forespørsel er et miljøproblem, like lite som noen mener at én bilreise er det.
Det internasjonale energibyrået anslo i sin rapport om energi og kunstig intelligens at verdens datasentre brukte rundt 415 terawattimer i 2024, altså omtrent 1,5 prosent av verdens elektrisitetsforbruk, og at dette vil mer enn dobles til rundt 945 terawattimer innen 2030. Kunstig intelligens pekes ut som den viktigste enkeltdriveren.
Men den samme rapporten inneholder et tall som sjelden siteres av dem som er mest bekymret: datasentre står for omtrent en tidel av veksten i verdens strømforbruk frem mot 2030. Det er mindre enn veksten fra industrimotorer, mindre enn veksten fra klimaanlegg i boliger og kontorer, og mindre enn veksten fra elbiler. I tillegg inneholder den et tall som er lett å glemme.
I moderne økonomier, der strømforbruket ellers har stått stille i mange år, står datasentre for over tjue prosent av veksten.
Poenget mitt er at begge tallene er riktige:
- Det første tallet gjør at jeg ikke aksepterer premisset om at kunstig intelligens er en klimakatastrofe i særklasse.
- Det andre gjør at jeg heller ikke aksepterer at dette er uproblematisk.
For Norge, med ren kraft og kaldt klima, er dette dessuten ikke en observasjon fra sidelinjen. Det er nettopp de egenskapene som gjør oss attraktive, og det gjør kraftbruken til datasentre til et norsk politisk spørsmål om prioritering av knapp kraft, ikke et amerikansk miljøspørsmål vi kan lese om.
Dette kommer jeg tilbake til mot slutten, for jeg mener strømforbruket og inngangsjobbene henger sammen på en måte som er lett å overse.
Slik ville et menneske gjort det
Et menneske ville kanskje brukt i underkant av fem sekunder per klipp for å vurdere om det inneholdt dialog og latter. Og dette mener jeg det er verdt å tenke over. Den som ser og hører de samme opptakene, gjenkjenner latteren umiddelbart og ufrivillig. Vi bestemmer oss ikke for at noe er latter, vi vet det før vi rekker å formulere hvorfor. Det er såkalt taus kunnskap. Det gjelder latter og gjenkjenning av et ansikt, for eksempel.
Der mennesket er overlegent, er altså i selve gjenkjenningen. Der mennesket taper, er i utholdenhet og skala. Oppmerksomheten svekkes etter tjue minutter med gjennomgang av råmateriale. To timer opptak krever realistisk tre til fire timers arbeid for å logges ordentlig. Og en hel harddisk med 120 turer ville tatt uker.
Enda viktigere å understreke i denne sammenhengen er at et menneske kan gjenkjenne, men ikke telle på samme måte som en maskin. Vi skalerer på to vidt forskjellige måter. På samme måte er menneskelig og maskinell intelligens også helt forskjellig.
Dette leder meg inn i en diskusjon jeg har vært opptatt av lenge, og som jeg skriver mye om i boken min, Mennesket vs Maskinen.
Vi har en tendens til å bruke mennesket som fasit for alle former for intelligens. Maskinen tenker ikke, fordi den ikke tenker som oss. Den forstår ikke, fordi den ikke forstår som oss. Den er ikke kreativ, fordi den ikke skaper ut fra de samme erfaringene og følelsene som oss.
Fredrik A. Dahl, som har doktorgrad i maskinlæring og er seniorforsker ved Norsk Regnesentral, brukte en presis analogi om dette i en Aftenposten-kronikk i 2025. Definerer vi det å fly som det fugler gjør, kan vi konkludere med at et helikopter ikke flyr. Det har ikke fjær, legger ikke egg og kan ikke lande på en telefonledning.
Helikopteret flyr likevel. Det flyr bare på en annen måte. Prosjektet med Møysalen-opptakene er den beste illustrasjonen jeg selv har produsert på nettopp dette.
Maskinen har ingen opplevelse av humor. Den har ikke vært på tur med Rikard. Den vet ikke hva det vil si å le sammen med noen du har kjent i mange år. Den kan ikke huske noe av det, og den kommer aldri til å savne det. Den fant likevel latteren. Det betyr ikke at den forstår hva latter er, men fordi den har lært seg å gjenkjenne et fysisk mønster i luft som lar seg måle, og fordi mennesker har brukt tid på å merke tusenvis av slike mønstre slik at en modell skulle kunne kjenne dem igjen.
Dette er verken forståelse eller juks, men en reell kapasitet. Jeg har tidligere argumentert for at diskusjonen om maskinbevissthet ofte fungerer som en avledning. Så lenge vi krangler om hvorvidt modellen føler noe, slipper vi å ta stilling til hva den faktisk kan settes i stand til å gjøre.
Latterprosjektet mitt er hverdagslig og ufarlig. Men mekanismen er den samme som i de tilfellene som ikke er ufarlige.
//Artikkelen fortsetter etter annonsen//
Maskinen tok feil 26 ganger
Av de 49 klippene markerte Claude selv 26 som usikre. Det er en vesentlig del av historien, og den delen som oftest faller ut når slike prosjekter omtales.
Vind mot mikrofonen ligner på latter. Et enkeltstående rop kan ligne på latter. Transkripsjonen gikk i loop flere steder og produserte mye tull, fordi det å tyde norsk og svensk tale (Rikard er fra Sverige) i kuling er krevende, også for en stor språkmodell. Leveransen var derfor ikke ett svar, men en rangert tabell basert på hypoteser et menneske – altså meg – måtte vurdere. Der ligger hele forskyvningen. Maskinen flyttet arbeidet mitt fra å lete til å vurdere, og den flyttingen fungerer bare så lenge det finnes noen som faktisk kan vurdere.
Jeg skrev i sommer om da den samme AI-assistenten fant et reelt sikkerhetshull på nettstedet mitt, og i samme samtale ga meg en teknisk forklaring som var fullstendig oppdiktet.
Den hørtes nøyaktig like sikker ut begge ganger.
Forskerne fra Harvard, MIT, Wharton og Warwick som fulgte 758 BCG-konsulenter, fant det samme mønsteret: konsulentene presterte klart bedre enn før på oppgaver innenfor modellens kompetanseområde, og målbart dårligere på en oppgave som lå like utenfor.
Forskjellen mellom de to situasjonene er enorm. Men uten egen dømmekraft er forskjellen usynlig.
Arbeidet jeg automatiserte bort er inngangsjobben
Her kommer den delen jeg har et ordentlig ambivalent forhold til. Å gå gjennom råmateriale, logge klipp, notere tidskoder, skrive ut dialog og sortere ut de brukbare bitene er klassisk assistentarbeid i videoproduksjon. Det er kjedelig. Det er tidkrevende. Og det er nettopp derfor det har vært lagt til de yngste.
Det er også slik man lærer. Man ser tusen klipp og begynner etter hvert å se forskjell på et klipp som fungerer og et som ikke gjør det. Man utvikler dømmekraft ved å behandle store mengder middelmådig materiale. Ingen blir en god klipper av å lese om klipping.
Mitt lille prosjekt kostet meg ingenting utover Claude-abonnementet mitt på 200 kroner i måneden. Hadde jeg satt bort den samme jobben til en frilanser, anslår jeg åtte til tolv timers arbeid, og med norske frilansrater havner det fort på rundt 10.000 kroner som et anslag.
Men det er her jeg må være ubehagelig ærlig: Det ville jeg aldri vært villig til å betale. Det menneskelige oppdraget hadde aldri funnet sted. Derfor var det ingen som mistet et oppdrag da Claude gikk gjennom Møysalen-opptakene. Det er det sterkeste motargumentet mot min egen bekymring, og jeg synes det fortjener å stå.
Kunstig intelligens erstatter ikke bare arbeid. Den skaper arbeid som aldri var økonomisk forsvarlig å la et menneske utføre.
//Artikkelen fortsetter etter annonsen//
Strøm og inngangsjobber er samme mekanisme målt i to enheter
Her er det jeg sitter igjen med, og det er den observasjonen jeg mener er viktigst i hele teksten.
Jeg vurderte aldri om latteren på Møysalen var verdt 0,4 kilowattimer. Jeg tenkte ikke på det i et sekund. Jeg vurderte heller ikke om den var verdt en læringsmulighet for en 23-åring. Men i begge tilfeller har det samme skjedd: produksjonskostnaden har falt så nær null at selve beslutningsøyeblikket forsvinner. Ikke beslutningen om hva jeg skulle gjøre, men øyeblikket der jeg måtte vurdere om det var verdt det i det hele tatt.
Dette er kjernen når det kommer til friksjon. Friksjon oppleves som irritasjon, og fjernes derfor med god samvittighet. Men friksjon er også det som får oss til å stoppe opp. Hadde jeg måttet ringe en frilanser og avtale en pris, ville jeg vært tvunget til å svare på om jobben var verdt noe. Hadde jeg måttet sette av en lørdag til å spole gjennom opptak selv, ville jeg vært tvunget til det samme. Nå blir jeg ikke tvunget til noe som helst.
Var dette uetisk?
Nei, det mener jeg oppriktig ikke, og jeg kommer nok til å gjøre det igjen med hele arkivet. Men grunnen til at det ikke var uetisk, er utelukkende at det var én jobb. Det eneste som skiller én slik jobb fra ti millioner, er at ingen teller. Det gjelder begge deler. Ingen teller kilowattimene, og ingen teller de juniorstillingene som ikke ble utlyst.
Begge forsvinner på samme måte, uten at noen tar en beslutning, uten at noen protesterer, og uten at noen i ettertid kan peke på hvor det skjedde.
//Artikkelen fortsetter etter annonsen//
Fire ting jeg mener vi bør gjøre nå
Tre av disse fire er ledelsesoppgaver som løses i den enkelte virksomhet, ikke på Stortinget. Den fjerde er det motsatte, og jeg skal komme tilbake til hvorfor.
For det første bør virksomheter som automatiserer juniorarbeid være i stand til å svare på hvor læringen flyttes. Hvis et byrå sparer to hundre timer i året på logging og research, er det et helt rimelig krav at ledelsen kan gjøre rede for hva de yngste gjør i stedet, og hvilken kompetanse det bygger. Spart tid som ikke kan gjøres rede for, er ikke en gevinst. Det er en utsatt regning.
For det andre bør juniorer settes til å overprøve maskinens arbeid fra første dag, med reelt ansvar for konklusjonen. Ikke som en formalitet der de rydder opp i formateringen, men som den som faktisk skal si om resultatet holder. Det er den eneste måten jeg kan se at dømmekraft bygges når selve utførelsen er automatisert. Det krever at noen med erfaring sitter ved siden av, og det krever at feil er tillatt.
For det tredje bør vi se på om lærlingordningen kan ha noe å lære oss om kunnskapsarbeid. Norge har en sterk tradisjon for strukturert opplæring i fagene, med krav til bedriften, til veiledningen og til innholdet. For kunnskapsarbeid har vi ingenting tilsvarende (ikke som jeg vet om i alle fall), og det er akkurat der inngangsjobbene nå forsvinner raskest. Jeg påstår ikke at ordningen lar seg kopiere direkte. Men jeg mener det er en samtale vi ikke har tatt.
For det fjerde bør vi kunne se tallene. Google begynte i fjor å publisere energi- og vannforbruk per forespørsel. Metoden er selvrapportert, den gjelder korte spørsmål og utelater både resonnerende modeller og bilder, og den er kritisert av gode grunner. Den er likevel uendelig mye bedre enn ingenting, og de fleste andre leverandører, Anthropic inkludert, publiserer ikke slike tall i det hele tatt. Uten dem kan verken jeg som bruker eller en innkjøper i en norsk kommune utøve den dømmekraften jeg ellers etterlyser i denne teksten. Dette er den ene av de fire tingene som faktisk egner seg for regulering, og et europeisk krav om standardisert og revidert rapportering ville være et rimelig sted å begynne.
Noen deler av dette har ingen god løsning. En del av det arbeidet jeg beskriver kommer ikke tilbake, uansett hva vi gjør. Jeg mener det er på sin plass å skrive det også.
//Artikkelen fortsetter etter annonsen//
Latteren ligger ikke lenger på en harddisk
Jeg sitter altså nå igjen med 13 minutter med Rikard og meg selv, hentet ut av to timer jeg ellers sannsynligvis aldri ville åpnet og sett på igjen. Det som slår meg mest, er ikke at maskinen klarte det, men hvor lite jeg forsto rekkevidden av det før jeg så resultatet.
Jeg har et helt arkiv fra seks år med turer. Det kan nå søkes i på innhold. Ikke bare etter latter, men etter stillhet, utsikt, fugleperspektiv (drone-shots), soloppganger, kaffekos utenfor teltet, eller alle de gangene vi krangler om hvor vi skal gå.
Jeg kan be Claude finne materialet, be Suno komponere musikk til stemningen, slik jeg gjorde med Mera Peak-filmen min fra våren 2026 i Nepal, og få Claude til å sette det sammen til noe som forteller den historien jeg vil formidle. Dusjer jeg én gang mindre den samme uken, kan jeg forsvare det.
Abonner på YouTube-kanalen min nå
//Artikkelen fortsetter etter annonsen//
I min første bok, Tilkoblet og til stede, skrev jeg om hvordan teknologien trekker oss bort fra det fysiske og menneskelige. Her skjedde det motsatte. Teknologien ga meg tilbake et par timer sammen med bestevennen min som jeg ellers hadde regnet som tapt. På den andre siden representerer dette også den samme kapasiteten som fjerner den første jobben til noen som er 23 år og skal lære seg dette faget.
Begge deler er sanne samtidig. Det er ikke en motsetning vi kan tenke oss bort fra, men en avveining noen må ta stilling til, og som per i dag i altfor stor grad blir tatt av oss som bare synes det er praktisk.
Verktøyene som ble brukt:
Alt som er brukt i dette prosjektet er fritt tilgjengelig, og alt er kjørt på to prosessorkjerner uten grafikkort.
- Lyd og video: ffmpeg og ffprobe for uttrekk av lyd, stillbilder og selve utklippingen uten ny komprimering.
- Stemmedeteksjon: Silero VAD, for å finne hvor det i det hele tatt snakkes.
- Lydanalyse: librosa for mel-spektrogrammer, SciPy for filtrering av sannsynlighetskurven og NumPy for all tallbehandling.
- Lattergjenkjenning: Jon Gillick, Wesley Deng, Kimiko Ryokai og David Bamman, «Robust Laughter Detection in Noisy Environments», Interspeech 2021. Kode og modellvekter på GitHub. Modellen er trent på Switchboard-korpuset og gjort støyrobust med AudioSet.
- Stemmeavtrykk: Resemblyzer, basert på Li Wan, Quan Wang, Alan Papir og Ignacio Lopez Moreno, «Generalized End-to-End Loss for Speaker Verification», Google 2017.
- Talegjenkjenning: OpenAIs Whisper, beskrevet i Alec Radford m.fl., «Robust Speech Recognition via Large-Scale Weak Supervision», 2022. Kjørt gjennom sherpa-onnx fra k2-fsa-prosjektet.
- Kjøring og optimalisering: PyTorch og ONNX Runtime.
- Orkestrering og vurdering: Anthropics Claude, som satte sammen kjeden, rettet feilene i den fem år gamle koden, optimaliserte den, leste transkripsjonene, så på stillbildene og rangerte funnene.
//Artikkelen fortsetter etter annonsen//
Kilder:
- Hjerneforskningen på latter: Fausto Caruana og Sophie Scott, gjennomgang publisert i Trends in Neurosciences, juni 2026.
- Helikopteranalogien: Fredrik A. Dahl, seniorforsker ved Norsk Regnesentral, kronikk i Aftenposten 2025.
- Sysselsetting blant unge: Stanford Digital Economy Lab, «Canaries in the Coal Mine? Six Facts about the Recent Employment Effects of Artificial Intelligence», oppdatert august 2026.
- Nye jobber og KI-ferdigheter: Det internasjonale pengefondet, «New Jobs Creation in the AI Age», SDN/2026/001.
- BCG-studien: Fabrizio Dell’Acqua, Edward McFowland III, Ethan Mollick m.fl., «Navigating the Jagged Technological Frontier», Harvard Business School Working Paper, 2023.
- Energiforbruk i datasentre: Det internasjonale energibyrået, «Energy and AI», 2025.
- Energi og vann per forespørsel: Google Cloud, «Measuring the environmental impact of AI inference», august 2025, og MIT Technology Review om hva tallene ikke dekker.
- Vannforbruk i datasentre: Environmental and Energy Study Institute om kjølevann og vann til kraftproduksjon, og Network World om Amazons egenrapporterte WUE-tall for 2025.
